Síntesis de voz local en un MacBook: 136x tiempo real y el problema del acento
¿Hasta dónde llega un portátil con la síntesis de voz sin ninguna nube? Probé dos modelos abiertos y pequeños de texto a voz, Kokoro y Silero, en un MacBook con M3 Pro y 18 GB de RAM, primero en inglés y después en ruso.
Versión corta: la voz en tiempo real en un portátil es un problema resuelto, y ambos modelos son tan rápidos que la velocidad deja de importar. Lo difícil no es la voz. Es saber qué sílaba acentuar.
Kokoro: 82 millones de parámetros
Kokoro-82M es un modelo pequeño, con licencia Apache-2.0 y 54 voces predefinidas. Di a cinco voces americanas la misma frase de 212 tokens, siete ejecuciones por voz tras un calentamiento. Aquí un token es un fonema, no una palabra: la frase se convierte en una cadena fonética antes de llegar al modelo.
| Voz | Audio | CPU | Velocidad CPU | GPU Apple (MPS) | Velocidad MPS |
|---|---|---|---|---|---|
| af_heart | 13,5 s | 1,41 s | 9,6x | 0,64 s | 21,2x |
| af_bella | 13,9 s | 1,47 s | 9,4x | 0,65 s | 21,4x |
| af_nicole | 20,6 s | 2,25 s | 9,1x | 0,91 s | 22,7x |
| am_michael | 14,9 s | 1,62 s | 9,2x | 0,68 s | 22,0x |
| am_fenrir | 13,8 s | 1,50 s | 9,2x | 0,66 s | 21,0x |
En TTS, los tokens por segundo engañan. af_nicole parece la más lenta, con 234 tokens por segundo frente a 333 de af_heart, porque es una voz lenta y baja y el tiempo de generación sigue a la duración del audio. Medida en múltiplos de tiempo real, es la más rápida de las cinco.
El arranque en frío importa más que la cifra principal. Cargar lleva unos dos segundos, y la primerísima generación en MPS tardó 5,6 segundos. Un asistente debería calentar el modelo antes de que alguien le hable.
Ruso por la puerta de atrás
Kokoro no tiene ruso. Si le das cirílico a su flujo en inglés no falla nada: translitera el texto y lee los nombres de las letras.
Pero el modelo de voz no sabe nada de idiomas. Solo ve fonemas. Así que puedes saltarte la parte inglesa, pedir los fonemas rusos a espeak-ng y pasárselos directamente al modelo:
phonemes, _ = EspeakG2P(language="ru")(text)
# No están en el vocabulario de Kokoro: se pierden sin ningún aviso.
phonemes = phonemes.replace("ɭ", "l").replace("ɵ", "o")
audio = KPipeline.infer(model, phonemes, voice_pack).audio
Esa línea con replace me costó una ejecución. espeak escribe la «л» rusa como ɭ, un símbolo que Kokoro no tiene, así que al principio todas las «л» desaparecían del habla en silencio. Nada falló. Solo lo delató el recuento de fonemas.
Funciona, a unas 22x tiempo real y con acento americano. Un truco divertido más que una voz rusa.
La frase de prueba
Para el ruso escribí una frase pensada para hacer daño: homógrafos, donde solo el acento distingue dos palabras, y jerga informática tomada del inglés.
Тимлид позвонит в среду: деплой фичи стоит отложить, пока баг стоит в бэклоге. В старом замке сломался замок, договор на апгрейд застрял, а коммит в мастер — просто мука. Зато белая мука и творог по каталогу дешевле.
Más o menos: «El líder del equipo llamará el miércoles: conviene aplazar el despliegue de la funcionalidad mientras el bug sigue en el backlog. En el viejo castillo se rompió una cerradura, el contrato de la actualización está atascado y el commit a master es un auténtico tormento. Eso sí, la harina blanca y el requesón salen más baratos por catálogo».
Las trampas son los pares. сто́ит significa «conviene» y стои́т, «está parado». му́ка es tormento y мука́, harina. за́мке es un castillo y замо́к, una cerradura.
Silero: hecho para el idioma
Silero v5_6_ru es un modelo de 141 MB hecho para el ruso. Recibe texto normal, sin fonemizador externo, y coloca el acento por sí mismo.
| Voz | Audio | Generación | Velocidad |
|---|---|---|---|
| aidar | 13,1 s | 0,096 s | 136x |
| baya | 13,1 s | 0,097 s | 136x |
| kseniya | 12,7 s | 0,092 s | 137x |
| xenia | 11,2 s | 0,081 s | 137x |
| eugene | 9,8 s | 0,074 s | 133x |
Eso es en CPU, con PyTorch indicando un solo hilo al final de la ejecución. Trece segundos de habla en menos de una décima de segundo.
La pega es la licencia: los modelos de Silero son no comerciales, así que sirve para proyectos personales y no para un producto.
Por qué es tan rápido
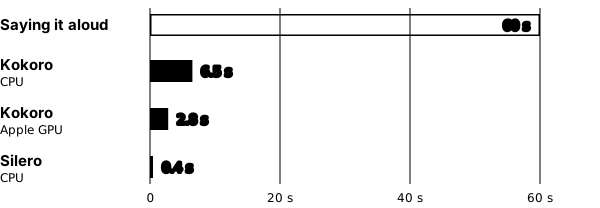
Tiempo para generar un minuto de voz, calculado a partir de la velocidad medida.
La voz es un trabajo más fácil de lo que parece. Un LLM tiene que decidir qué decir. Un modelo de voz ya tiene las palabras y solo debe convertirlas en sonido, con una voz que se sabe de memoria.
Además lo hace de una vez. Kokoro toma la frase entera y produce todo el audio en una sola pasada. Los modelos que clonan voces repasan el audio una y otra vez, y por eso los tres que probé en este portátil fueron más lentos que el tiempo real y no entraron en este artículo.
El acento es el problema de verdad
Un modelo de voz lee lo que le dan. Si el acento viene mal, pronuncia la palabra equivocada con seguridad y muy bien.
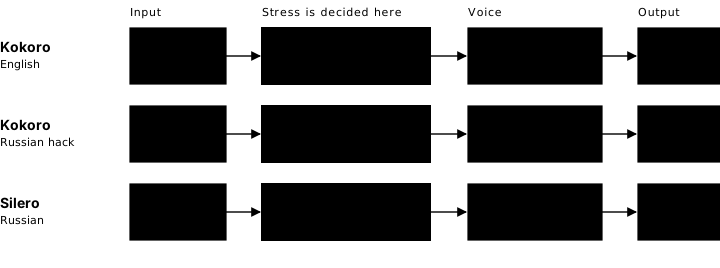
El acento se decide antes de que empiece el modelo de voz. Ese es el paso que merece la pena arreglar.
Con el montaje de Kokoro el acento se ve en los fonemas, así que pude comprobarlo. espeak-ng falló en tres de las doce palabras que seguí: де́плой en lugar de депло́й, стои́т en «conviene aplazar» y му́ка en «harina blanca». Escribe las dos мука igual porque no lee el contexto.
RUAccent es un modelo de acentuación aparte, y su salida es texto con marcas, así que también pude leerla. Acertó el par сто́ит/стои́т, que espeak no distinguía. Luego acentuó д+еплой, marcó dos acentos en к+омм+ит y convirtió el tormento en harina. Mejor, pero no resuelto.
Silero oculta sus fonemas, así que la única forma de juzgarlo es escuchar. La buena noticia es que acepta acento manual: un + antes de la vocal.
model.apply_tts(text="Белая мук+а — просто м+ука", speaker="eugene", sample_rate=48000)
Automático frente a marcado
El mismo modelo y la misma voz, primero con el acento propio de Silero y después con marcas. Primero un par corto:
Y después la frase de prueba completa, con este marcado:
Тимл+ид позвон+ит в ср+еду: депл+ой ф+ичи ст+оит отлож+ить, пок+а б+аг сто+ит в бэкл+оге.
В ст+аром з+амке слом+ался зам+ок, догов+ор на апгр+ейд застр+ял, а комм+ит в м+астер —
пр+осто м+ука. Зат+о б+елая мук+а и твор+ог по катал+огу деш+евле.
La respuesta práctica tiene dos capas. Un pequeño diccionario para tu propia jerga, porque ningún modelo ha oído a tu equipo decir «деплой»: деплой → депл+ой, aplicado a todas sus formas. Y para los homógrafos, que los marque quien escribe el texto. Si un LLM produce la respuesta de todos modos, ya sabe a qué мука se refiere, y pedirle un + no cuesta nada.
Marcar a mano tiene su propia trampa. Comprobé mi marcado solo contra mi propia seguridad y fallé коммит a la primera. La jerga informática no tiene diccionario, así que tiene que escucharla alguien que de verdad diga esas palabras.
Qué usaría
- Inglés, cualquier cosa en directo: Kokoro. Rápido, pequeño, Apache-2.0.
- Ruso, proyectos personales, cualquier cosa en directo: Silero, con un diccionario de acentos encima.
No probé cómo leen números y abreviaturas. Las pruebas y los scripts se montaron con Claude Code.
Modelos y herramientas
Todo lo que aparece en este artículo salió de estos sitios:
- Pesos y voces de Kokoro-82M: hexgrad/Kokoro-82M en Hugging Face. Código de inferencia: hexgrad/kokoro, versión 0.9.4.
- Silero
v5_6_ru: snakers4/silero-models, cargado contorch.hub. Los pesos son un único archivo. - Fonemas: misaki para inglés, espeak-ng para ruso.
- Acento: RUAccent.
- Transcripciones para comprobar: whisper-large-v3-mlx.