Jerry: un terminal de voz sobre un ESP32-S3
A principios de octubre llegó un paquete pequeño: una Freenove ESP32-S3 Display, una placa con pantalla táctil de 2,8", micrófono, altavoz y un códec de audio ES8311. La idea era simple. Ya tengo un agente de IA en un servidor; quería un objeto físico en la mesa con el que simplemente hablar. Decir una palabra, preguntar, oír la respuesta. Sin móvil ni pestaña del navegador.
Dos semanas y tres reescrituras del firmware después, funciona y responde al nombre «Jerry». Esta es la versión corta de cómo llegó hasta ahí.
La placa
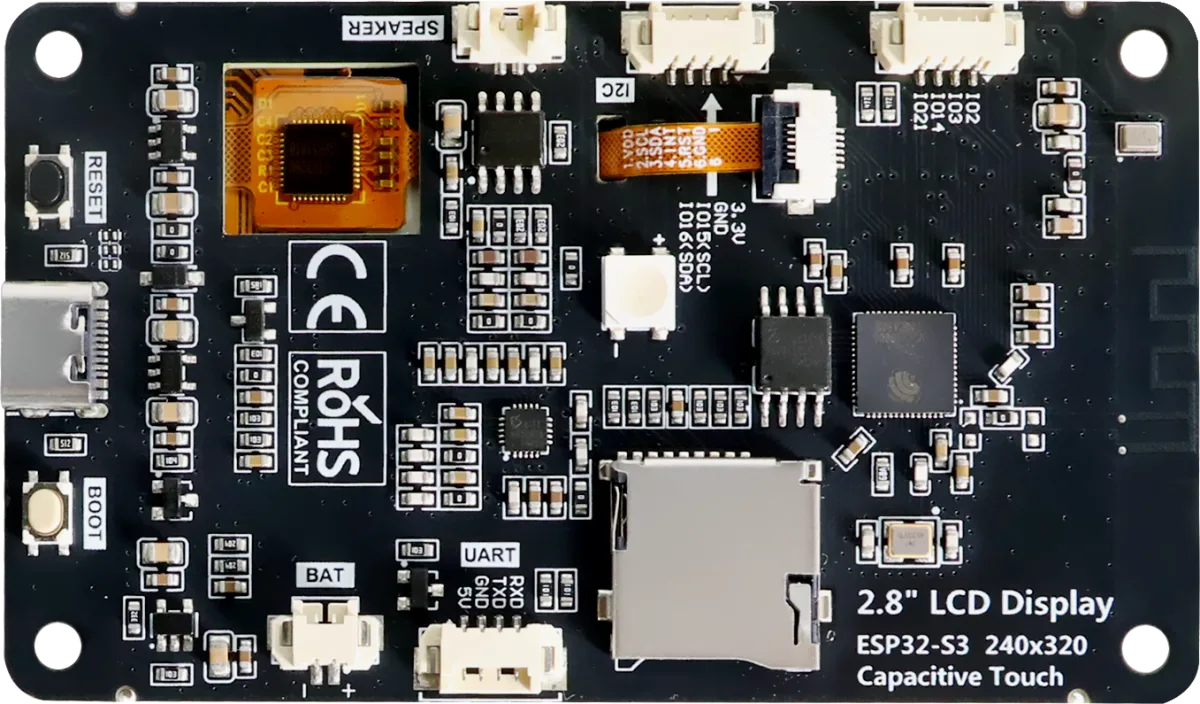
El reverso de la placa: módulo ESP32-S3 a la derecha, códec y amplificador en el centro, conectores de altavoz y batería, microSD, USB-C. Foto: Freenove, CC BY-NC-SA 3.0
El ESP32-S3 es un microcontrolador de dos núcleos a 240 MHz con Wi-Fi, instrucciones vectoriales para DSP y, en este módulo, 8 MB de PSRAM junto a 16 MB de flash. Para un microcontrolador es mucho. Para «ejecutar un modelo de palabra de activación, cancelar el eco, mantener una conexión TLS y dibujar una interfaz a la vez» resultó no ser suficiente. El límite real es la RAM interna: la PSRAM es lenta y algunas cosas, como los búferes de Wi-Fi y TLS, quieren la memoria rápida.
Primer intento: hacerlo como un teléfono
El primer firmware, sobre ESP-IDF, era un cliente bastante gordo. Enviaba PCM por WebSocket a un puente de voz delante de una sesión de OpenAI Realtime, dibujaba un chat en la pantalla y más tarde intentó detectar la palabra de activación en la propia placa con los modelos de voz de Espressif.
Funcionaba, más o menos. También se entrecortaba en respuestas largas, perdía de vez en cuando la primera frase de la conversación, cortaba la conexión cuando la pila TLS entraba en pánico bajo carga, y la detección en la placa era más lenta que la del servidor, no más rápida. Cada función nueva competía por la misma RAM interna.
Segundo intento: el firmware de otros
Cambié el back end a OpenClaw, una pasarela de agentes de código abierto con su propio firmware de nodo para ESP32. Su pipeline de audio es excelente: el dúplex completo y la cancelación de eco están claramente hechos por gente que sabe de audio. Su interfaz no es para mí, y adaptar su firmware a mi pantalla y a mi flujo se convirtió en una pelea con código que no era mío.
Así que probé una tercera vía: mi propio cliente de OpenClaw en la placa, con palabra de activación, cancelación de eco acústico, firmas Ed25519 y JSON-RPC, todo en el chip. La placa no pudo. Ahí la arquitectura se volvió evidente.
Tercer intento: placa delgada y un puente
La placa ahora hace tres cosas y nada más: envía el audio del micrófono, reproduce lo que recibe y dibuja la pantalla. Tramas PCM de veinte milisegundos, de forma continua, incluso el silencio. Todas las decisiones viven en un pequeño servicio en Rust al que llamo el puente.
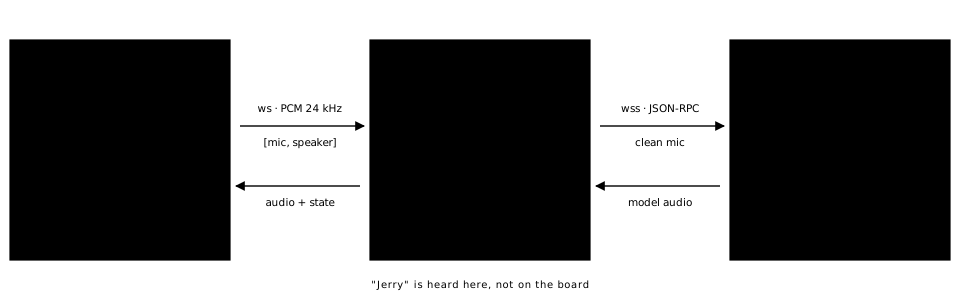
Qué corre dónde. La placa es un micrófono, un altavoz y una pantalla; el puente toma todas las decisiones; la pasarela mantiene la sesión con el modelo de voz.
El puente:
- Palabra de activación con openWakeWord sobre ONNX Runtime. La placa envía audio todo el tiempo; el puente escucha la palabra.
- Sesiones con la pasarela del agente: se abren con la palabra o un botón, se cierran tras 20 segundos de silencio o a petición.
- Ritmo. El audio del modelo llega a ráfagas más rápido que el tiempo real; el puente lo dosifica a 1x con un pequeño adelanto, así que interrumpir detiene la reproducción en un cuarto de segundo.
- Cancelación de eco. La placa envía una trama estéreo: el canal del micrófono y el del altavoz que reprodujo en el mismo tick de I2S. El puente resta el eco con speexdsp y reenvía al modelo un micrófono limpio. Puedes hablar por encima del asistente y se calla.
El firmware se redujo varias veces, la memoria dejó de ser tema, y el puente es software de servidor normal que puedo probar con un WAV y sin hardware.
Enseñarle «Jerry»
Los modelos preentrenados conocen «Hey Jarvis». No conocen «Jerry», y menos aún «Jerry» dicho en ruso. Así que entrené uno en local, en un Mac: muestras sintéticas con Piper TTS, unas decenas de grabaciones de mi propia voz, ruido de fondo y respuestas al impulso de habitaciones, y después el pipeline de entrenamiento de openWakeWord. El primer modelo cazaba la pronunciación inglesa e ignoraba por completo la rusa. El segundo, con mis grabaciones mezcladas, acierta 4 de 4 muestras reservadas con unos 0,6 falsos disparos por hora de ruido. Suficiente para una mesa.
Cómo es usarlo
La pantalla es un chat pequeño, porque eso es una conversación con un agente. Lo mío a la derecha, el asistente a la izquierda, los mensajes de servicio en el centro. La cabecera muestra si el puente está conectado a la pasarela OpenClaw, cuántas sesiones ha habido hoy y el volumen. Un par de cosas alrededor de las que está construida la interfaz, todas específicas de OpenClaw:
- La capa de tiempo real no tiene manos. El modelo de voz de OpenClaw es solo una voz; todo lo que haya que hacer va al agente del servidor, y el agente tiene las herramientas. Así que «Jerry, ¿está el sitio arriba?» es una pregunta de verdad: la voz dice «déjame comprobarlo», el agente ejecuta la comprobación y la respuesta vuelve hablada y en pantalla. Para mí ese es el sentido del aparato: un terminal hacia el agente que ya gestiona mis cosas, no un altavoz inteligente.
- Las sesiones cuestan dinero. Una sesión Talk se factura mientras está abierta, así que la interfaz es honesta con eso: un pitido ascendente al abrirse, uno descendente al cerrarse, un contador en la cabecera, «Stop» en pantalla y cierre automático tras 20 segundos sin que nadie hable. Ninguna sesión se queda colgada porque alguien se fue.
- Se puede interrumpir. Habla por encima del asistente o pulsa «Interrumpir» y se detiene en un cuarto de segundo: la pasarela envía un clear, el puente vacía la cola, la placa vacía su búfer. Los intercambios cortos funcionan mejor que los monólogos.
- Es un objeto de mesa. El botón BOOT sube el volumen por pasos, la pantalla se atenúa a los 20 segundos y la placa se reconecta sola al puente si el Wi-Fi tropieza. Nada en él pide un teclado.
Casi todo esto se construyó junto con Claude Code, del firmware al puente en Rust y al pipeline de entrenamiento. El siguiente paso: mover el puente del portátil al servidor, para que el terminal funcione con el portátil cerrado.