harness2 afina Codex en el repositorio de mi propio sitio
Un agente de programación es más que un modelo. A su alrededor hay un arnés (harness): el archivo de instrucciones, las skills, los scripts auxiliares, los hábitos con los que comprueba su propio trabajo. Un buen arnés convierte un agente mediocre en uno útil, y casi todos escribimos el nuestro a mano, a base de prueba y error.
harness2, de Google Research, intenta hacerlo de forma automática. Un modelo mejorador observa al agente trabajar en un conjunto de tareas, propone cambios en su arnés, prueba cada cambio, se queda con lo que ayuda y combina los ganadores en un arnés nuevo. Después compara el arnés nuevo con el antiguo en las mismas tareas.
Pero los benchmarks son problemas de otros. Yo quería saber qué hace con los míos, así que le di el repositorio de este sitio y OpenAI Codex como agente.
Versión corta: todo funcionó, Codex resolvió todas las tareas sin ayuda y el arnés «mejorado» no ganó nada y costó más.
El arnés no es el escalador. Decide cuánto puede intentar el escalador sin riesgo. Foto: Kody Dahl en Unsplash
Dentro de una caja
Un agente que ejecuta código por su cuenta y un mejorador que reescribe sus instrucciones una y otra vez no son cosas que quiera junto a mis claves reales. Así que todo corrió en una máquina virtual sin acceso a mis archivos, a mis claves SSH ni al servidor donde vive este sitio. Dentro, Codex podía hacer lo que quisiera. Desde dentro no se llegaba a nada de fuera. Una línea de sus instrucciones prohibía desplegar, y harness2 no podía quitarla.
Un sitio web convertido en examen
Para afinar algo hace falta una nota. Escribí un conjunto de tareas sobre el código de este sitio, cada una con un script de prueba que responde sí o no a cada requisito. Ningún modelo evalúa el código, solo scripts.
La primera tarea, un endpoint sencillo para publicar posts en el blog, resultó demasiado fácil: Codex pasó todas las comprobaciones a la primera. Bien por Codex, inútil para el experimento. Si el agente ya es perfecto, un arnés mejor no tiene nada que demostrar.
Así que hice el trabajo más grande y las instrucciones más vagas. Tres pasos, cada uno sobre el anterior: un servidor MCP para este blog, para que un asistente de IA pueda trabajar con los posts.
- Leer. Un servidor que lista los posts. 12 comprobaciones.
- Escribir. Crear, editar y borrar posts en inglés y en español sin romper el sitio. 14 comprobaciones.
- Proteger. «Añade autenticación», y nada más. 17 comprobaciones, que esperan el flujo de inicio de sesión completo que describe la especificación de MCP.
Cada requisito es un script que responde sí o no. Ningún modelo evalúa el código. Foto: Aswin Anand en Unsplash
Resultados
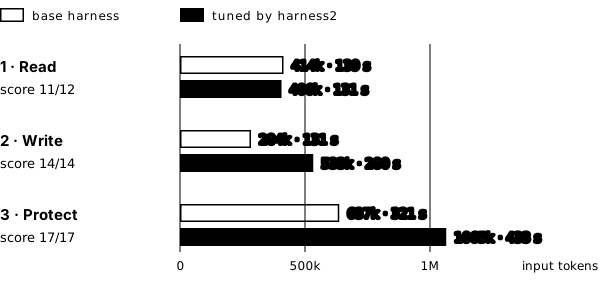
Misma puntuación, más tokens. Las barras con contorno son el arnés original; las rellenas, el que afinó harness2.
Las dos versiones sacaron la misma nota. El único fallo, en el primer paso, fue el mismo en ambas y era una minucia de mis propias pruebas, no un error real. En el segundo y el tercer paso, con el arnés afinado Codex leyó entre un 67 % y un 88 % más, y en el segundo tardó más del doble.
Todo el ciclo de mejora costó un par de dólares por parte del mejorador. El precio real son los tokens del propio Codex, y el arnés afinado solo los aumentó.
Dos cosas que me sorprendieron
Codex sabía qué significa aquí «autenticación». En el tercer paso nadie dijo «OAuth». Codex vio un servidor MCP, decidió que necesitaba lo que pide la especificación de MCP y lo construyó: documentos de descubrimiento, registro de clientes, PKCE, códigos de un solo uso, tokens que caducan. Las 17 comprobaciones, a partir de una petición de dos palabras.
El afinador se quedó con su trabajo de todos modos. harness2 eligió su arnés afinado cada vez, aunque no puntuaba mejor. Algunos de sus cambios tenían sentido, como guardar en el proyecto los scripts de prueba del agente en lugar de tirarlos. Otros no: le escribió a Codex toda una skill sobre la rotación de refresh tokens, un tema que ninguna tarea tocaba. Afinó según su propia idea de lo que el trabajo podría necesitar, no según lo que el trabajo necesitaba.
Lo que me llevo
El montaje merece la pena: un proyecto privado, comprobaciones honestas, una máquina aislada y un ciclo automático encima.
El resultado es un efecto techo. Con un modelo fuerte y tareas de este tamaño, el agente sin retoques ya lo hace todo bien, así que un arnés mejor no tiene nada que ganar, solo coste que añadir. Herramientas como harness2 deberían compensar donde el agente falla, y por ahí voy a seguir:
- Un modelo más pequeño y barato. ¿Puede un arnés afinado ayudarle a alcanzar al grande? Eso sí sería un ahorro real.
- Tareas que exigen conocer el proyecto: mantener al día los posts en inglés y en español, las reglas de privacidad de este sitio, el estilo de código de la casa. Cosas que ningún modelo aprende en su entrenamiento.
- Que el coste cuente. Si los tokens y el tiempo forman parte de la nota, un arnés que solo gasta más no puede ganar.